
Site down, কিন্তু CPU 12% — সমস্যাটা server-এর সংখ্যায় না
একটা Senior Backend Engineer ইন্টারভিউ থেকে শেখা: সব metric green, তবু site down। Connection pool contention, noisy neighbor, retry storm আর মিথ্যা health check নিয়ে একটা production reality check।
Hira Hasan
2026-09-23 · 9 min read
একটা ইন্টারভিউ, আর একটা production scenario
কিছুদিন আগে একজন Senior Backend Engineer-এর ইন্টারভিউ নিচ্ছিলাম।
Resume ভালো।
Redis জানে। Kafka জানে। Microservices জানে। System Design নিয়েও confident।
সব ঠিকঠাকই চলছিল।
তারপর আমি একটা production scenario দিলাম।
“Site down.
App CPU 12%.
Primary DB CPU normal.
Health checks সব green.
What do you do?”
উত্তর এলো:
“আরও app server add করব।”
আমি বললাম,
“Okay.”
তারপর জিজ্ঞেস করলাম:
“একটা tenant যদি connection pool-এর 70% ধরে রাখে, extra app serverগুলো কীসের জন্য wait করবে?”
Silence.
আরেকটা প্রশ্ন।
“Checkout আর 3-year export যদি একই pool share করে, তাহলে কে হারবে?”
Silence.
আরেকটা।
“Retry loop-এ jitter না থাকলে, একই 100টা connection-এর ওপর কতগুলো failed request আবার একসাথে ফিরে আসবে?”
আরেকটা।
“/health যদি checkout-এর path-ই না হয়, তাহলে green health check দিয়ে আপনি আসলে কী prove করলেন?”
এখানেই interviewটা interesting হয়ে গেল।
কারণ অনেক engineer architecture জানে।
কিন্তু system failure বোঝে না।
আর এই দুইটা এক জিনিস না।
“Site down” শুনেই scale করা engineering না
Production incident-এ খুব common একটা reflex আছে:
Traffic problem?
Server বাড়াও।
Latency?
Server বাড়াও।
Timeout?
Server বাড়াও।
Site down?
আরও server।
Cloud আমাদের একটা dangerous habit শিখিয়েছে:
Capacity problem আর coordination problem-কে একই জিনিস ভাবা।
সব সমস্যা compute problem না।
CPU 12%।
তার মানে machine-এর কাজ করার ক্ষমতা আছে।
কিন্তু request কাজ করছে না।
তাহলে খুব সম্ভবত request compute করছে না।
Request অপেক্ষা করছে।
Senior engineer-এর প্রথম instinct হওয়া উচিত:
কীসের জন্য অপেক্ষা করছে?
Low CPU অনেক সময় good news না
ধরুন DB connection pool-এ 100টা connection আছে।
একটা tenant 70টা ধরে রেখেছে।
বাকি পুরো system-এর জন্য 30টা।
এখন checkout request আসল।
CPU available।
Memory available।
App process alive।
Database-ও alive।
কিন্তু checkout একটা DB connection পাচ্ছে না।
তখন flowটা roughly এমন:
Request আসে।
Code execute হয়।
DB connection চায়।
Connection নেই।
Wait.
Wait.
আরও wait.
Timeout.
CPU তখনও low।
কারণ CPU কাজ করছে না।
সে অপেক্ষা করছে।
এখানে low CPU healthy system-এর signal না।
বরং low CPU আপনাকে বলছে:
“আমি কাজ করতে চাই। কিন্তু আমাকে কাজ করতে দেওয়া হচ্ছে না।”
Database CPU normal? Great. Maybe requests database পর্যন্তই পৌঁছাচ্ছে না
অনেক incident call-এ একটা line শোনা যায়:
“DB CPU তো fine.”
এটা শুনে সবাই একটু relax করে।
করা উচিত না।
Database CPU low থাকার মানে database healthy—এটা automatically true না।
Requests যদি connection pool-এই আটকে থাকে, database busy হবে কেন?
কাজ database পর্যন্ত পৌঁছাচ্ছে না।
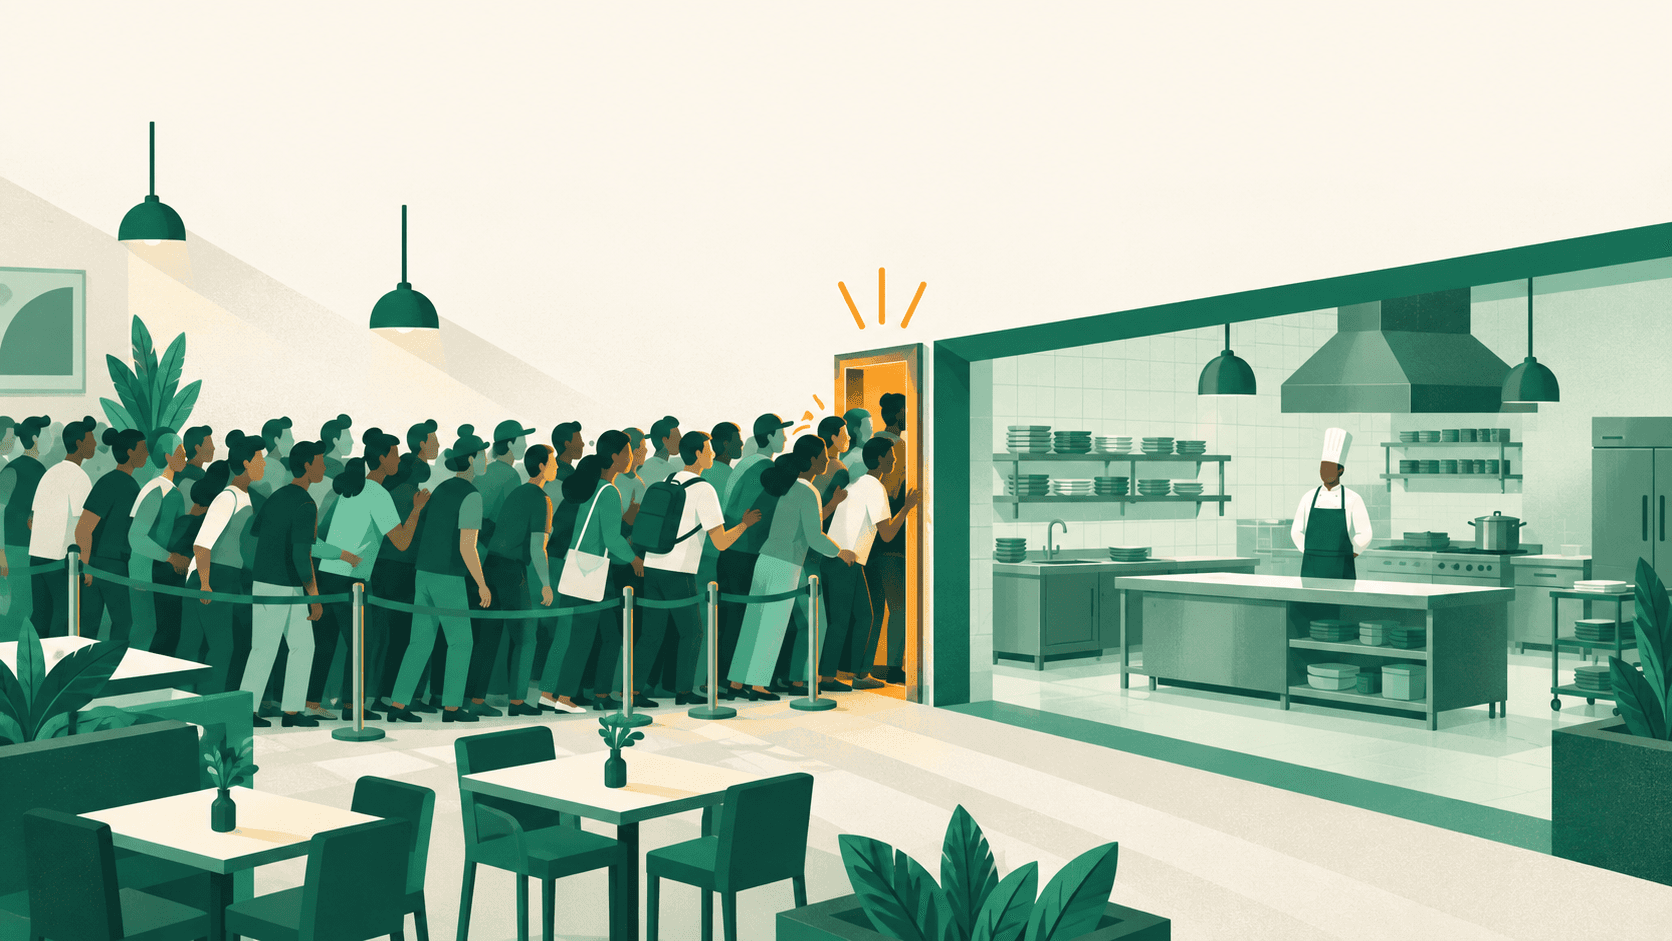
এটা এমন:
Restaurant-এর kitchen empty।
Chef দাঁড়িয়ে আছে।
কেউ বলল:
“Kitchen utilization তো low. সব ঠিক আছে।”
না।
হতে পারে kitchen-এর দরজাই jam হয়ে আছে।
Customer বাইরে।
Order ভেতরে ঢুকছে না।
Chef idle।
Customer angry।
Dashboard green।
Production system এভাবেই আপনাকে মিথ্যা comfort দেয়।
Extra app server bottleneck fix করে না
এখন ধরুন আমি সত্যিই আরও app server add করলাম।
তারপর?
আরও process।
আরও thread।
আরও request handler।
আরও DB connection demand।
কিন্তু scarce resource একই।
Database connection।
Connection limit।
Lock।
Downstream capacity।
Queue।
যেটাই হোক।
আপনি bottleneck remove করেননি।
আপনি bottleneck-এর সামনে অপেক্ষা করা মানুষের সংখ্যা বাড়িয়েছেন।
এটা scaling না।
এটা queue বড় করা।
আর কিছু ক্ষেত্রে extra app server situation আরও খারাপ করে।
যদি প্রতিটা instance নিজের 100-connection pool খুলতে পারে, তাহলে নতুন instance মানে database-এর ওপর আরও aggressive connection pressure।
Application tier scale হলো।
Database dependency scale হলো না।
তারপর সবাই অবাক হয়:
“Server বাড়ানোর পর outage আরও খারাপ হলো কেন?”
কারণ আপনি system-এর throughput বাড়াননি।
আপনি contention বাড়িয়েছেন।
Checkout আর 3-year export একই pool-এ রাখা architectural laziness
সব workload equal না।
Checkout latency-sensitive।
User button চাপল।
সে এখন response চায়।
একটা export job latency-sensitive না।
ওটা queue-তে যেতে পারে।
Background-এ চলতে পারে।
Throttle করা যায়।
Replica-তে পাঠানো যায়।
Per-tenant limit দেওয়া যায়।
কিন্তু যদি checkout আর three-year export একই connection pool share করে, তাহলে আপনি effectively বলছেন:
“Revenue-generating critical traffic আর massive batch job—দুটোর priority একই।”
এটা design decision।
Accident না।
ধরুন export connection ধরে রাখছে 30 seconds।
Checkout-এর দরকার ছিল 40 milliseconds।
কিন্তু checkout connection পেল না।
Result?
Export চলছে।
Checkout মরছে।
System technically operational।
Business practically broken।
এটাই noisy-neighbor problem।
একটা tenant যদি shared resource dominate করতে পারে, তাহলে multi-tenant architecture আসলে isolated না।
শুধু logically multi-tenant।
Operationally সবাই একই oxygen tank share করছে।
একজন বেশি টানলেই বাকিরা হাঁপাবে।
Retry অনেক সময় resilience না, denial-of-service
Engineers retry ভালোবাসে।
Failure?
Retry.
Timeout?
Retry.
Dependency slow?
Retry.
কিন্তু retry একটা load generator।
এটা ভুলে গেলে disaster খুব দ্রুত আসে।
ধরুন 2,000টা request timeout করল।
সব request exactly 1 second পরে retry করল।
কী হলো?
2,000টা request আবার একসাথে ফিরে এলো।
কিন্তু pool size এখনও 100।
আবার timeout।
আবার retry।
আবার herd।
একটা overload এখন self-sustaining overload হয়ে গেল।
System নিজের ওপর নিজেই traffic attack চালাচ্ছে।
এটাই কারণ retry-তে শুধু “retry” থাকলেই হয় না।
দরকার:
Exponential backoff।
Jitter।
Retry budget।
Bounded attempts।
Circuit breaker।
Backpressure।
সব retry equal না।
একটা smart retry system recovery help করে।
একটা stupid retry loop outage amplify করে।
Green health check সবচেয়ে dangerous lie হতে পারে
আমার favorite production irony:
Dashboard সব green।
Customer কিছুই করতে পারছে না।
কীভাবে?
খুব সহজ।
/health হয়তো করছে:
Process alive?
Yes.
Return 200.
কিন্তু checkout করছে:
Auth.
Connection pool.
Database.
Inventory.
Payment provider.
Transaction.
Confirmation.
এখন /health green।
Checkout dead।
দুটো simultaneously true।
কারণ আপনি healthy কী, সেটাই ভুল define করেছেন।
Liveness বলে:
“Process মরে যায়নি।”
Readiness বলে:
“Traffic নেওয়ার মতো অবস্থায় আছি।”
Business health বলে:
“User আসলে তার কাজটা করতে পারছে।”
Production system-এ শেষেরটাই সবচেয়ে গুরুত্বপূর্ণ।
কারণ customer Kubernetes pod-এর heartbeat কিনতে আসে না।
Customer checkout করতে আসে।
Metrics green মানেই system green না
এখানে বড় ভুলটা technical না।
Mental model-এর।
আমরা individual component দেখি।
CPU.
Memory.
DB CPU.
Pod status.
Health endpoint.
তারপর ধরে নিই system healthy।
কিন্তু distributed system component-এর collection না।
Distributed system হলো interaction-এর network।
আর outage অনেক সময় component failure থেকে আসে না।
আসে coordination failure থেকে।
একটা pool full।
একটা queue backed up।
একটা lock held।
একটা tenant greedy।
একটা retry loop synchronized।
একটা downstream dependency slow।
সব machine alive।
System dead।
আমি interview-এ আসলে কী test করছিলাম
আমি Redis command জিজ্ঞেস করছিলাম না।
Kafka trivia-ও না।
আমি দেখতে চেয়েছিলাম candidate symptom দেখলে কী করে।
Solution jump করে?
নাকি system interrogate করে?
Senior engineer-এর কাজ সবসময় answer জানা না।
Senior engineer-এর কাজ ঠিক questionটা করা।
“CPU কত?”
Useful.
কিন্তু আরও useful:
“Request কোথায় wait করছে?”
“Pool acquisition latency কত?”
“কতজন waiter আছে?”
“Longest-held connection কার?”
“Tenant-wise resource usage কী?”
“Retry traffic original traffic-এর কত গুণ?”
“Checkout আর export একই resource share করছে কেন?”
“Health endpoint কি business-critical dependency touch করছে?”
এই প্রশ্নগুলো incident solve করে।
“Server বাড়াই?” অনেক সময় শুধু incident expensive করে।
System Design box drawing competition না
Load balancer আঁকা সহজ।
Kafka আঁকা সহজ।
Redis বসানো সহজ।
Microservice boundary আঁকাও সহজ।
Whiteboard-এ system খুব সুন্দর দেখানো যায়।
Production whiteboard না।
Production nasty।
একটা innocent-looking connection pool পুরো platform নামিয়ে দিতে পারে।
একটা batch export checkout starve করতে পারে।
একটা retry policy traffic multiply করতে পারে।
একটা green health check সবাইকে ভুল confidence দিতে পারে।
এবং সবশেষে incident channel-এ কেউ লিখবে:
“Infra looks healthy.”
এই sentence-এর পরেই আমার প্রশ্ন হবে:
User healthy?
কারণ শেষ পর্যন্ত সেটাই matter করে।
Seniority technology list দিয়ে বোঝা যায় না
Redis জানেন?
ভালো।
Kafka জানেন?
ভালো।
Kubernetes?
আরও ভালো।
কিন্তু Senior Backend Engineer হওয়ার আসল জায়গা শুরু হয় যখন সব obvious metric normal, তবু system broken।
তখন textbook answer কাজ করে না।
তখন দরকার reasoning।
Resource ownership।
Contention।
Isolation।
Backpressure।
Failure amplification।
Queueing।
Observability।
এগুলো না বুঝে microservices জানাটা খুব বেশি দূর নিয়ে যায় না।
Production system আপনাকে syntax দিয়ে test করে না।
সে test করে:
চাপের মধ্যে আপনি bottleneck দেখতে পান কি না।
Site down হলে আমি প্রথমে জিজ্ঞেস করব না:
“আরও server লাগবে?”
আমি জিজ্ঞেস করব:
“সবাই কোথায় আটকে আছে?”
কারণ অনেক outage-এ server কম থাকে না।
থাকে না শুধু enough access to the one resource everyone needs.